mortred_model_server
模型服务器配置参数说明
所有的模型服务器参数配置均存放在 $PROJECT_ROOT_DIR/conf/server 文件夹。
常规配置参数
以 mobilenetv2 图像分类服务器为例
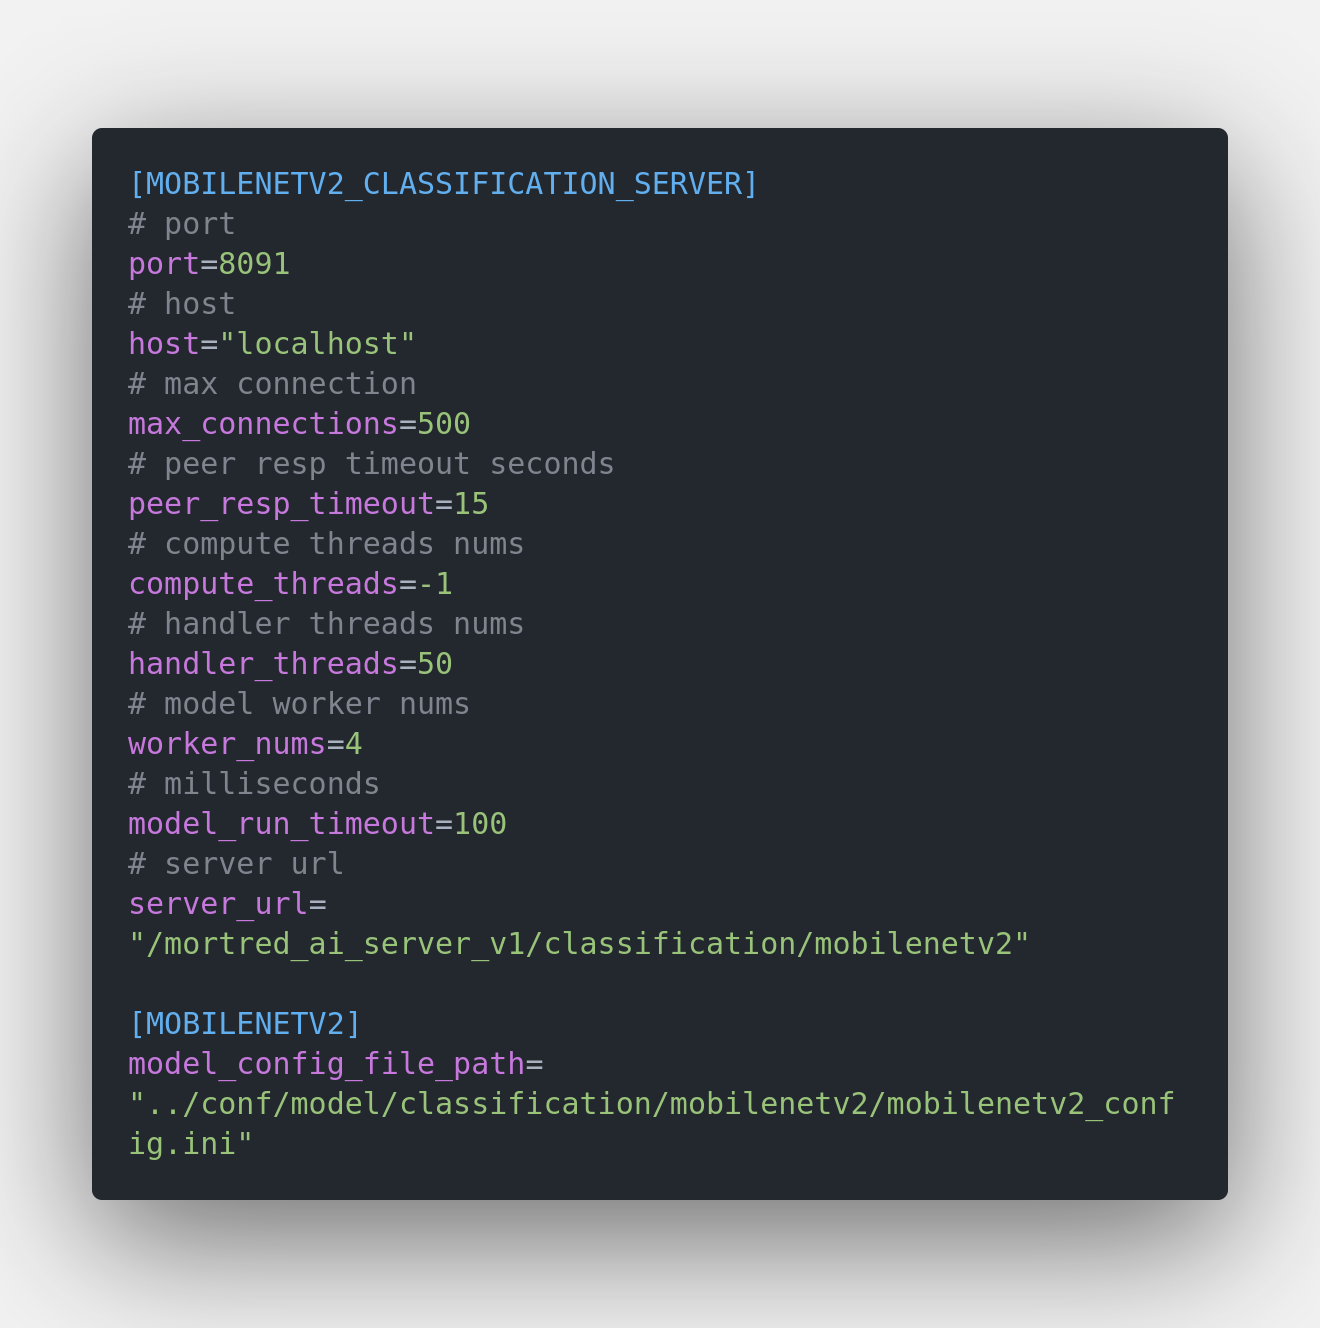
host: 服务host地址
port: 服务端口号
max_connections: 服务支持的最大连接数。旧连接会被踢出如果超过最大连接数。在没有连接可用的情况下新的连接请求会被拒绝。并发量大时可以增大这个参数。有用讨论见 #issue463, #issue906 and tutorial-05-http_proxy
peer_resp_timeout: 服务读取和发送一段数据的超时设置,默认15秒。
compute_threads: 计算线程池的线程数, -1 代表使用默认值即cpu的核心数。
handler_threads: 处理网络任务、回调函数的线程个数
model_run_timeout: 模型inference的超时设置,超时的任务会被中断,-1代表该值无限大。
server_uri: 模型进程上的 HTTP 路径(网关遗留匹配)。例:/mortred_ai_server_v1/classification/mobilenetv2。走网关时优先 POST /v1/models/{id}/infer。
model / server_exe: catalog id 与 mortred-model-server.out。
model_config_file_path: 写在 [MODEL] 表(不是 *_SERVER 表)。见 about_model_configuration。
其他一些网络服务参数配置
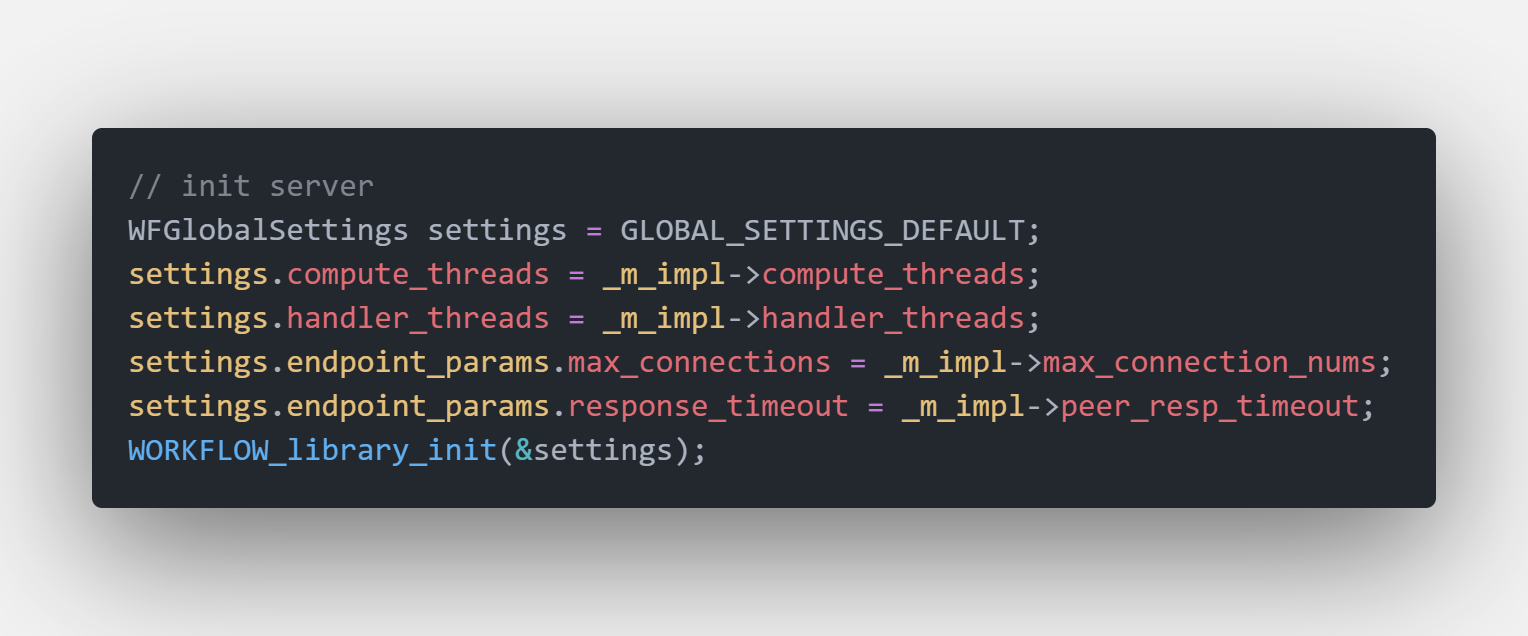
其余一些有关网络服务的全局配置可以参考 workflow_docs_about_global_configuration
Listen / timeout / worker 参数写在对应的 conf/server/**/*.toml 里。Workflow 级默认值在 src/server/base_server_impl.h 里统一设置,由 mortred-model-server.out --model <ID> 服务所有模型。
workflow全局配置参数代码段
过载保护与动态批处理(可选)
详细语义见 HTTP API 契约 · 过载行为。
# 等待队列上限:超过后立即返回 429 + Retry-After(0 = 不限制)
max_queue_depth=32
# 产品 server 保持关闭凑批。大于 1 会把并发请求打成一次推理;
# static batch-1 的 TensorRT engine 不走这条路径。
max_batch_size=1
# 批收集窗口毫秒数:首条请求到达后最多等待这么久凑批
max_batch_delay_ms=5
队列上限调优公式:max_queue_depth ≈ worker_nums × 目标排队秒数 / 单次推理时长(秒)。