mortred_model_server
这是一个面向单机 CPU/GPU 的 CV 推理设备:一个 catalog id = 一个 OS 进程。客户端打 mortred-gateway(:8080);监督器(:8787)管进程树。推理后端是 MNN、ONNX Runtime 和 TensorRT,HTTP 层用 workflow。训练仍在 tensorflow / pytorch 侧完成。
欢迎你反馈任何你发现的bug,本人还是一个c with struct 弱鸡 :upside_down_face:
权重用 python3 scripts/fetch_weights.py 从
Hugging Face 拉取。
HF 是 ONNX 交换格式仓库(切换期间仍有部分 MNN)。产品 conf 保持 mnn /
tensorrt(本来就是 ONNX 的 id 以及 LIBFACE YuNet 除外);engine 须本机
mortredctl prepare。合同见 conf/onnx_sources.json。双文件导出:
docs/onnx-interchange.zh-cn.md。
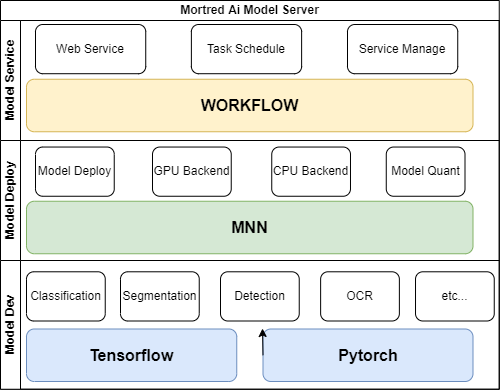
整个项目的简要架构图如下
欢迎你提出改进意见或者pr来帮助我把它建设的更好 :smile::fire:
文档目录
快速开始
Linux 是唯一受支持的平台。两条部署 profile,一个开关驱动构建、依赖、模型目录和权重子集:
gpu(默认)cpu后端 MNN-CUDA / ORT-CUDA / TensorRT MNN-CPU / ORT-CPU 硬件 NVIDIA GPU + CUDA 12 / TensorRT 10 任意 x64 模型 HTTP catalog 全量 精选(mobilenetv2、resnet50) 三个入口,同一套
mortredctl:选一条即可,终点都是mortredctl doctor。 完整运维手册见 docs/deployment.zh-cn.md。
入口一:一行 bootstrap(最快)
curl -fsSL https://raw.githubusercontent.com/MaybeShewill-CV/mortred_model_server/main/scripts/bootstrap.sh | bash
探测硬件(有 NVIDIA → gpu,否则 cpu)。有 Docker 则打印 compose 轨道。无
Docker 则解析 GitHub 最新 release tag,再下载
mortred_model_server-<version>-<profile>-linux-x64.tar.gz(没有
...-latest-... 这种 tarball 文件名)。若还没有 Release,则 WARN 并打印源码构建路径。
入口二:docker compose
git clone https://github.com/MaybeShewill-CV/mortred_model_server.git
cd mortred_model_server
python3 scripts/fetch_weights.py --profile cpu        # 或: gpu
./scripts/mortredctl_init-trust.sh                    # 三个互异 token
set -a && . conf/local/trust.env && set +a
docker compose --profile cpu up -d                    # 或: --profile gpu
curl -fs http://localhost:8787/api/v1/health
入口三:release tarball + systemd(裸机)
从 Releases
下载 mortred_model_server-<version>-<profile>-linux-x64.tar.gz,校验 .sha256,然后:
mkdir unpack && tar -xzf mortred_model_server-*-linux-x64.tar.gz -C unpack
cd unpack                                          # 平铺:install.sh、opt/、deploy/
sudo ./install.sh
sudo /opt/mortred/bin/mortredctl.out init-trust --force --out /etc/mortred/supervisor.env
cd /opt/mortred && python3 scripts/fetch_weights.py --profile cpu
sudo systemctl start mortred-supervisor
第一小时:mortredctl
mortredctl init [--profile cpu|gpu]
mortredctl init-trust
mortredctl init-edge --mode lan
mortredctl prepare [--pack FILE]
mortredctl calibrate [--pack FILE]
mortredctl doctor
mortredctl doctor --strict            # 缺 engine、缺占用 stamp、占用门关闭、安全警告都会失败
mortredctl status | catalog
GPU:用 mortredctl prepare 在本机转 当前 pack 的 TensorRT engine,不要默认转整个 zoo。见 部署说明 §10。
从源码构建
Cpu 源码构建:install_deps.sh --cpu --all && --cpu --check,再
cmake --preset full-cpu(详见 docs/deployment.zh-cn.md §7)。
手装 CUDA / MNN / WORKFLOW / OpenCV / TensorRT 不是快速开始;那是源码构建路径。 两条 CMake 路径:
- tests-only:只构建
common与单元测试(CI / 快速验证)。 - full build:全部模型与服务,需要
3rd_party下的引擎。
路径 A:tests-only
方案 A1 - 系统包(推荐,与 CI 一致):
sudo apt-get install -y build-essential cmake \
  libopencv-dev libgoogle-glog-dev libeigen3-dev libgtest-dev libssl-dev
# Ubuntu 22.04 的 libgtest-dev 自带预编译库与 CMake 配置,可直接 find_package(GTest)

cd $PROJECT_ROOT_DIR
cmake -B build -DMORTRED_BUILD_FULL=OFF
cmake --build build --target check -j10
ctest --test-dir build --output-on-failure
方案 A2 - vcpkg(可选;仅本地开发用,CI 不使用):
# 1. 安装 vcpkg(或复用已有实例)
git clone https://github.com/microsoft/vcpkg.git /path/to/vcpkg
/path/to/vcpkg/bootstrap-vcpkg.sh -disableMetrics

# 2. 配置(vcpkg 会按 vcpkg.json 自动安装 opencv/glog/eigen3/gtest)
cd $PROJECT_ROOT_DIR
cmake -B build -DMORTRED_BUILD_FULL=OFF \
      -DCMAKE_TOOLCHAIN_FILE=/path/to/vcpkg/scripts/buildsystems/vcpkg.cmake

# 3. 构建并运行单元测试
cmake --build build --target check -j10
ctest --test-dir build --output-on-failure
vcpkg.json 中故意不写死 builtin-baseline;若你的 vcpkg 实例要求显式 baseline,执行一次
vcpkg x-update-baseline --add-initial-baseline 后重新配置即可。
路径 B:full build
# 1. 校验/补齐 vendored 第三方依赖
#    (MNN / WORKFLOW / ONNXRUNTIME / TensorRT + CUDA)。
#    缺失时按提示设置对应的 *_ROOT_DIR 环境变量后重试。
./scripts/setup_full_deps.sh

# 2. 配置并构建
mkdir build && cd build
cmake ..            # 可选:追加 -DCMAKE_TOOLCHAIN_FILE=... 以同时使用 vcpkg
make -j10
默认可执行文件输出到 $PROJECT_ROOT_DIR/_bin,动态库输出到 $PROJECT_ROOT_DIR/_lib;
两者均可用 -DMORTRED_BIN_OUTPUT_DIR=... 与 -DMORTRED_LIB_OUTPUT_DIR=... 覆盖。
常用 CMake 选项:
| 选项 | 默认值 | 说明 |
|---|---|---|
MORTRED_BUILD_FULL |
ON |
构建全部模型/服务/工具(需要 CUDA 与 vendored 引擎);置 OFF 进入 tests-only 模式。 |
MORTRED_ENABLE_WERROR |
OFF |
将编译器警告视为错误(-Wall -Wextra -Werror),供 CI 质量门禁使用。 |
MORTRED_BIN_OUTPUT_DIR |
$PROJECT_ROOT_DIR/_bin |
可执行文件输出目录。 |
MORTRED_LIB_OUTPUT_DIR |
$PROJECT_ROOT_DIR/_lib |
动态库输出目录。 |
项目提供了 CMake Presets(见 CMakePresets.json):
cmake --preset tests-only
cmake --build --preset tests-only
# 该 buildPreset 默认 target 为 check(编译 EXCLUDE_FROM_ALL 测试并跑 ctest)
仓库目录规范与源码/配置/可执行文件映射见 docs/repository-layout.md。
Step 3: 下载项目提供的一些预训练模型 :tea::tea::tea:
通过内置脚本自动下载预训练模型(Hugging Face 源,无需手动下载):
cd $PROJECT_ROOT_DIR
python3 scripts/fetch_weights.py            # 下载全部权重到 weights/
python3 scripts/fetch_weights.py --check    # 校验完整性(sha256)
如果本机 GPU/TRT 版本与预置引擎不匹配,请按 部署说明 §10
为本机 pack 生成 engine(mortredctl prepare),不要默认转整个 zoo:
cd $PROJECT_ROOT_DIR
mortredctl prepare --pack conf/packs/yolov8.toml
完成后的文件夹结构应该如图所示。

Step 4: 测试 MobileNetv2 基准测试工具
至此你已经完成的项目的编译工作,可以开始测试体验项目提供的预训练模型了。统一基准测试入口是 $PROJECT_ROOT_DIR/_bin/mortred-model-benchmark.out,用 --model 选择 catalog 里的模型。
现在你可以通过如下方式来进行 mobilenetv2 图像分类基准测试
cd $PROJECT_ROOT_DIR/_bin
./mortred-model-benchmark.out --model MOBILENETV2 ../conf/model/classification/mobilenetv2/mobilenetv2.toml
如果没有任何错误的话(应该不会有:dog:),你可以看到如下的测试结果,包含使用的模型,模型预测耗时、fps等信息

Step 5: 运行 MobileNetV2 图像分类服务器
有关网络服务器的一些细节参数可以查看 网络服务器配置说明。下面让我们愉快的开启服务
cd $PROJECT_ROOT_DIR/_bin
./mortred-model-server.out --model MOBILENETV2 ../conf/server/classification/mobilenetv2/mobilenetv2_server_config.toml
按照默认的配置文件(conf/server/classification/mobilenetv2/mobilenetv2_server_config.toml),服务端口为9002,worker_nums=1 个模型 worker 等待被调用。项目中含有一个简单的python客户端来测试该服务,使用方法如下
cd $PROJECT_ROOT_DIR
python3 scripts/server/test_server.py --server mobilenetv2 --mode single --times 3
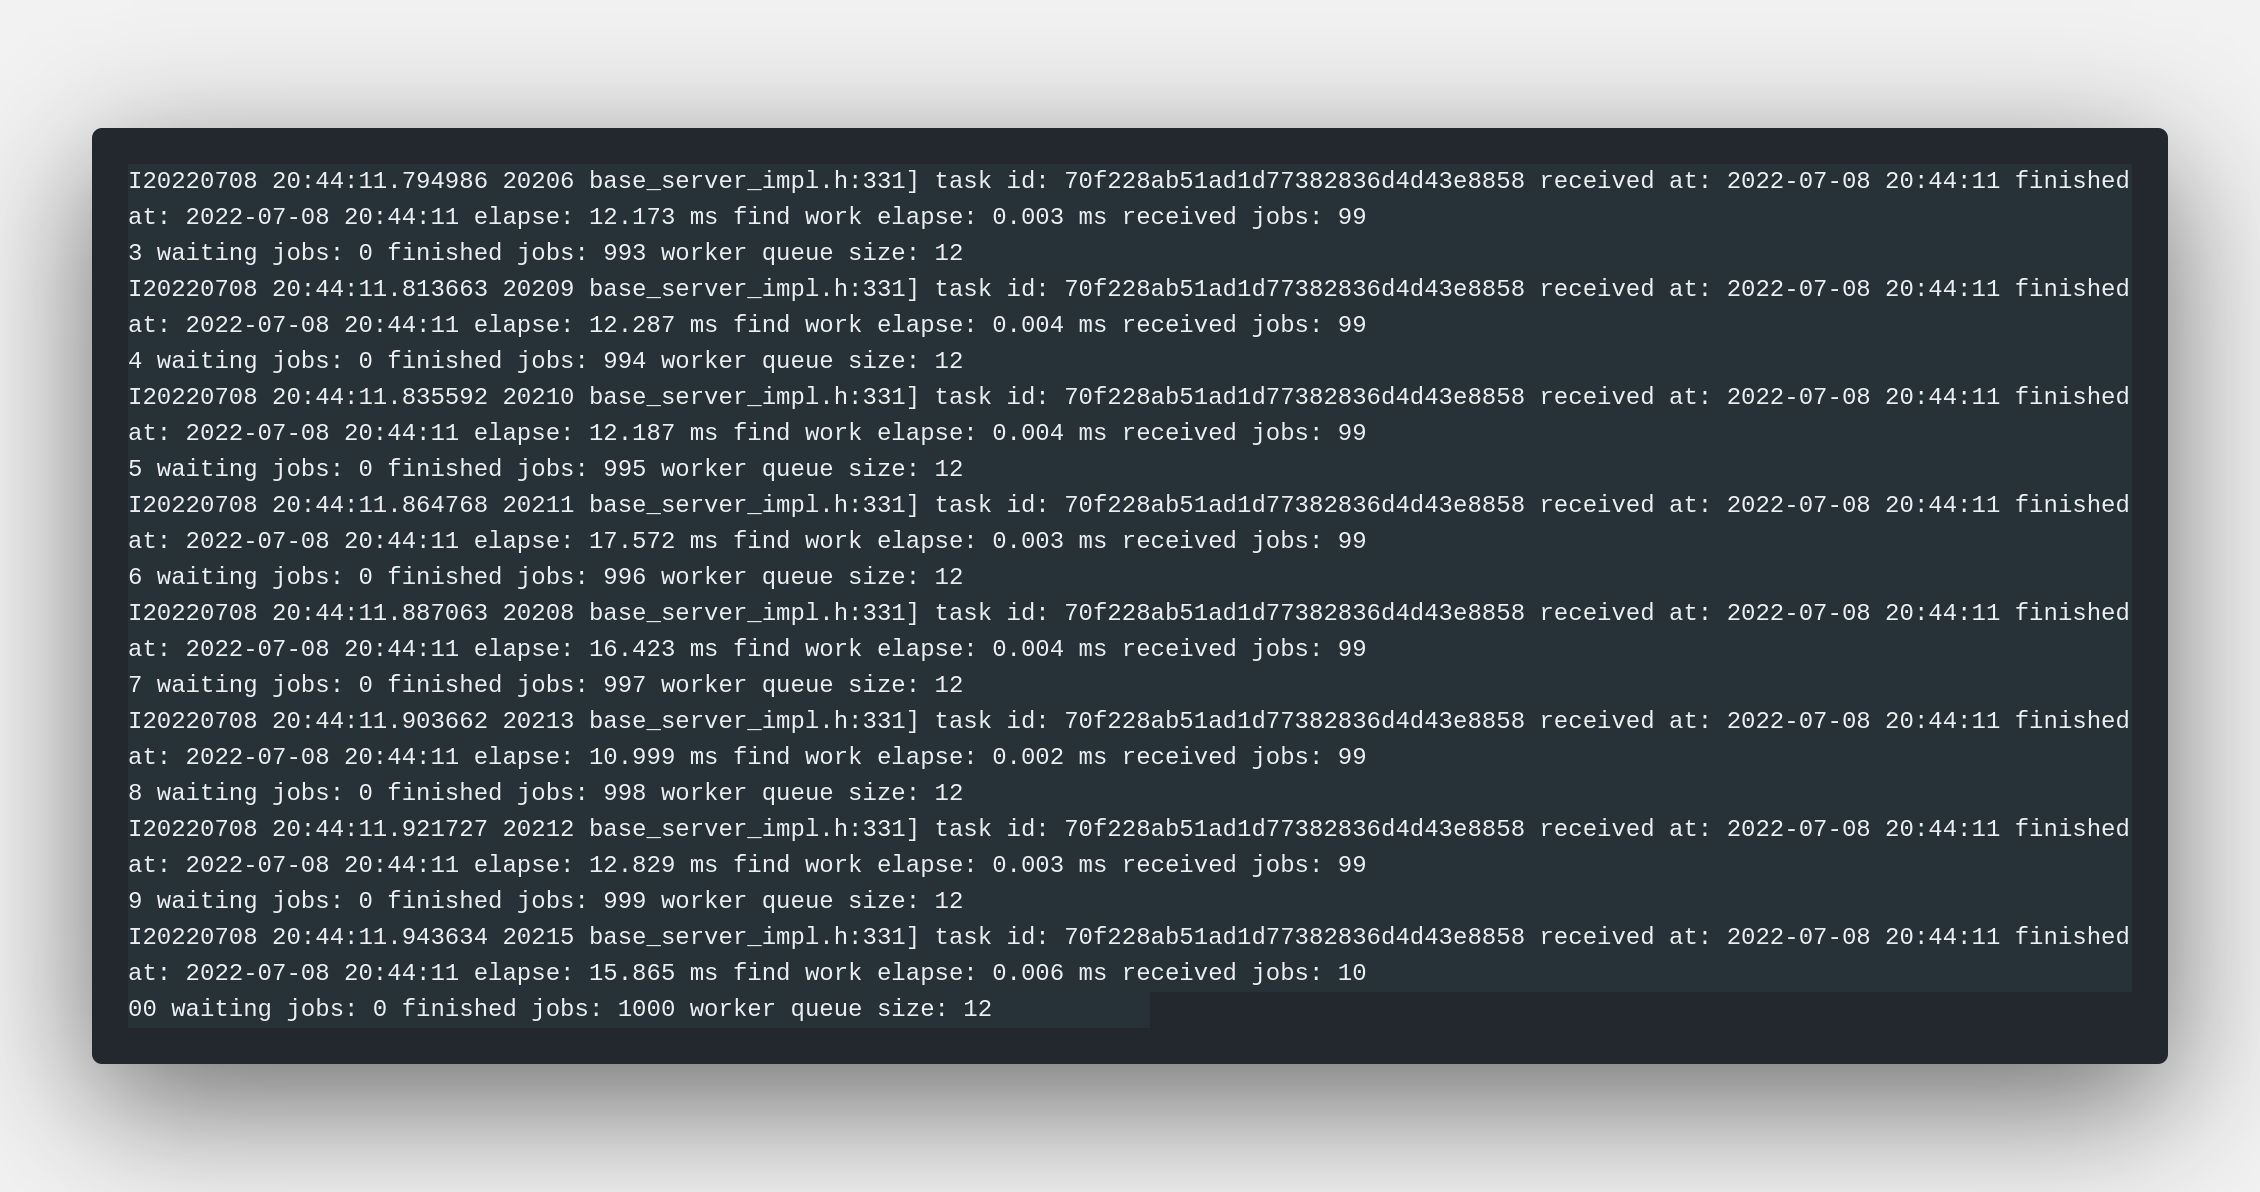
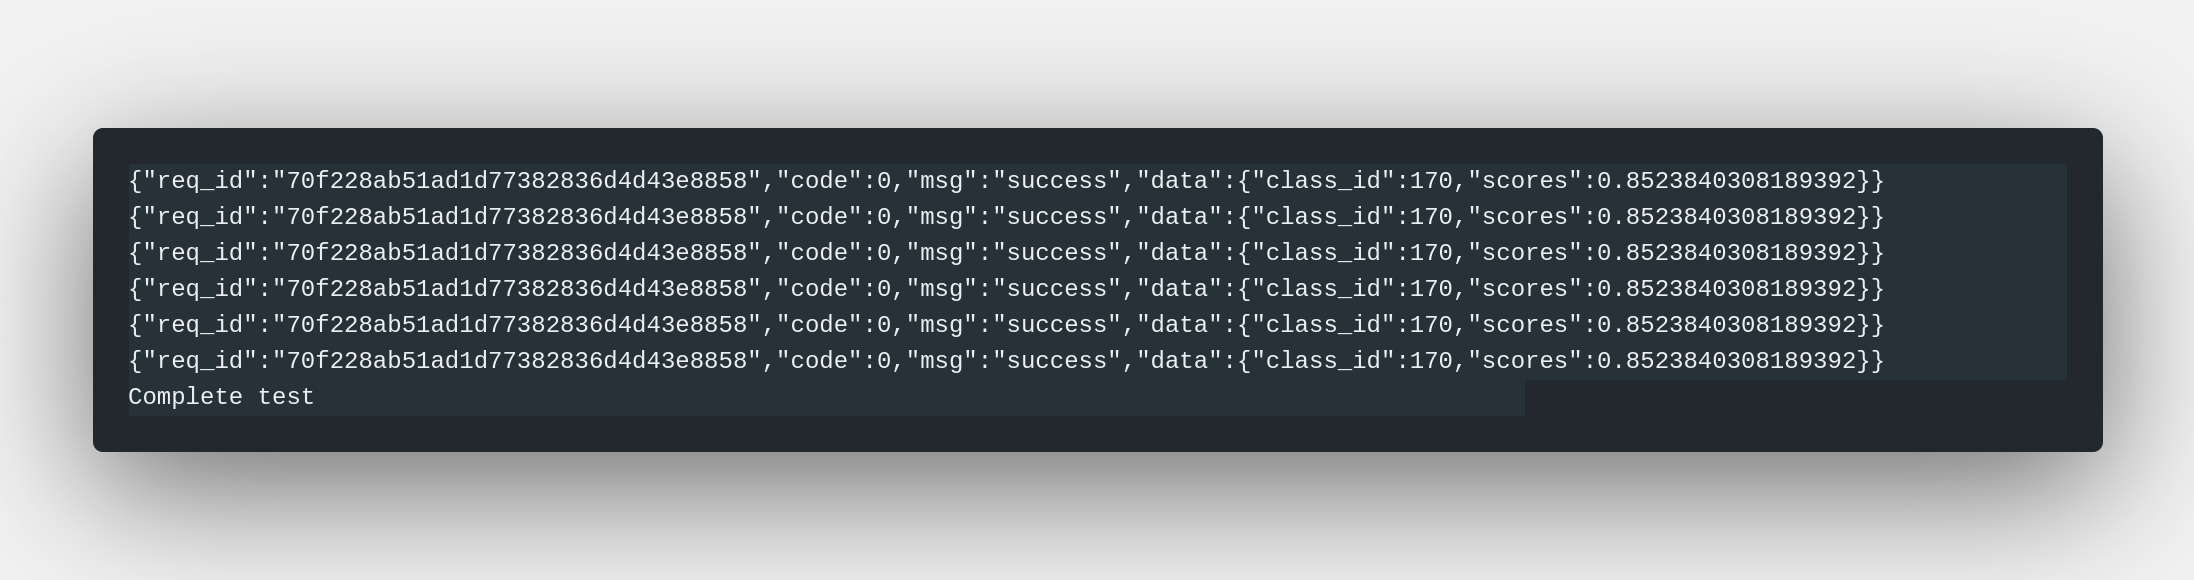
客户端 POST 统一信封(images[]),打印 HTTP 状态和截断后的 UnifiedResponse。分类结果在 results[].data。下面截图是历史输出(旧 {code,msg,data} 信封),不要当现行契约。
你可以在下文的 模型说明 章节获取更多的服务示例 :point_down::point_down::point_down:
Benchmark
基准测试环境如下:
OS: Ubuntu 20.04.5 LTS / 5.15.0-87-generic
MEMORY: 32G DIMM DDR4 Synchronous 2666 MHz
CPU: Intel(R) Core(TM) i5-10400 CPU @ 2.90GHz
GCC: gcc (Ubuntu 9.4.0-1ubuntu1~20.04.2) 9.4.0
GPU: GeForce RTX 3080
CUDA: CUDA Version: 11.5
GPU Driver: Driver Version: 495.29.05
DL模型推理基准测试
所有模型的测试过程都重复推理若干次以抵消GPU的warmup损耗,并且没有任何的io时间被算入
Benchmark 代码段
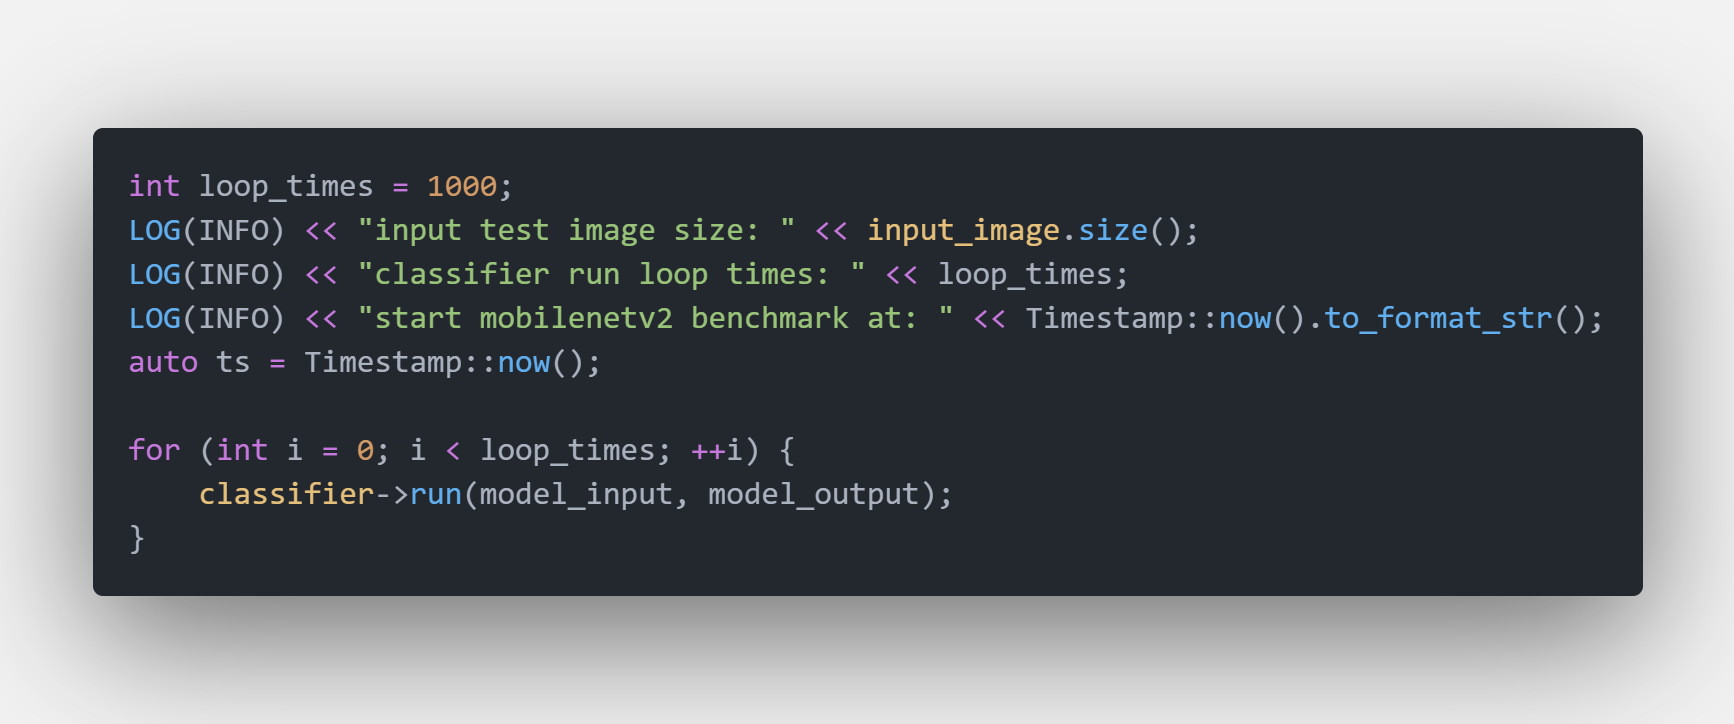
模型说明
文档教程
- 模型开发者指南(加模型 / 契约 / golden / 调试) :fire::fire:
- 快速添加新的DL服务 :fire::fire:
- 推理 CI(托管 MNN 冒烟 vs 维护者 GPU golden)
- ONNX 交换格式导出(双文件、缺口清单)
网络服务器配置说明
Model Zoo
HTTP 可服务(mortred-model-server.out --list / catalog id):
HTTP catalog id 为小写。YOLOV8、PPHUMAN_SEG 等旧名已删除,推理路径是 /v1/models/yolov8s/infer。msocrnet 已进入 HTTP。SAM_AMG 与扩散模型 id 保持原样。
| 任务 | Catalog id |
|---|---|
| 分类 | mobilenetv2 resnet densenet |
| 检测 | yolov5l yolov6s yolov7 yolov7x yolov8n yolov8s yolov8l yolov8x nanodet_1x5 nanodet_416 |
| 人脸 | libface centerface |
| OCR | dbnet |
| 分割 | bisenetv2 pphuman_mobile pphuman_lite pphuman_server hrnet msocrnet |
| 抠图 | modnet ppmatting_512 ppmatting_1024 ppmatting_resnet34 ppmatting_v2 |
| 增强 | enlightengan attentive_gan realesrgan |
| 特征点 | superpoint |
| 嵌入 | dinov2_vits14 dinov2_vitb14 dinov2_vitl14 |
| 深度 | depth_vits14 depth_vitb14 depth_vitl14 metric3d_512 metric3d_1088 |
| SAM | SAM_AMG |
| 扩散 | DDPM DDIM CLS_COND_DDIM LDM |
Bench-only(无 HTTP catalog):OPENAI_CLIP、LIGHTGLUE、SAM_PREDICTOR、FAST_SAM。
Scaffold、未实现、不在 HTTP catalog:RTDETR。无 MOT。
部署说明
一键安装第三方依赖
通过单个脚本把全部第三方依赖(MNN / WORKFLOW / ONNXRUNTIME / TensorRT / CUDA /
fmt / 头文件库)构建并安装进 3rd_party/{include,libs},无需手动编译与拷贝:
./scripts/install_deps.sh --all     # CUDA 12 / TensorRT 10.3 / MNN 3.6.1 / ORT 1.29 cuda12
./scripts/install_deps.sh --check   # 校验完整性并打印版本
Docker(全自动构建运行环境)
docker build -t mortred_model_server:gpu .
docker run --gpus all -p 127.0.0.1:8080:8080 -p 127.0.0.1:8787:8787 \
  -v $PWD/weights:/opt/mortred/weights \
  -e MORTRED_GATEWAY_AUTH_TOKEN=your-inference-token \
  -e MORTRED_API_TOKEN=your-management-token \
  -e MORTRED_METRICS_TOKEN=your-scrape-token \
  mortred_model_server:gpu
# 或:docker compose --profile gpu up -d(CPU:--profile cpu;见 docker-compose.yml)
镜像会自动构建全部依赖与完整项目、运行单元/e2e 测试并交付控制面;
模型权重通过 volume 挂载,不内置于镜像。容器内拓扑:mortred-supervisor
(管理面 :8787,内嵌 Web UI + REST API)监督 mortred-gateway(数据面
:8080,推理统一入口)与全部模型进程;模型进程仅绑定 127.0.0.1,不再
逐端口暴露。compose 与 docker run 示例把 8080/8787 绑在宿主机
127.0.0.1 上。对外暴露必须由主机网络上的 Nginx 终结 TLS
(mortredctl init-edge,deploy/nginx);不要在没有边缘时把
这些端口发到 0.0.0.0(Bearer 会明文传输)。网关 GET /metrics 在环回上也要
MORTRED_METRICS_TOKEN。缺推理/管理身份、缺 scrape token、scrape 与其它身份相同、
或未设 MORTRED_EXPOSE=docker|unsafe 的通配绑定都会拒绝启动。
mortredctl doctor 会对非环回监听、缺失 scrape token 和过短/相同的 token 告警;
doctor --strict 会因这些警告失败。TLS 仍在 Nginx 上终结。
TensorRT 引擎重建(硬件适配)
Engine 绑定本机 GPU / TRT。日常只转 当前 pack(见 部署指南 §10):
mortredctl prepare --pack conf/packs/yolov8.toml
全量 zoo 仍可用 scripts/convert_trt_engines.sh(需要 trtexec:
sudo ./scripts/install_deps.sh --nvidia)。MORTRED_AUTO_BUILD_ENGINES=true
会转整个 zoo,默认关闭。
TODO
- 增加更多的DL模型
开发状态

致谢
mortred_model_server 项目参考、借鉴了以下项目: